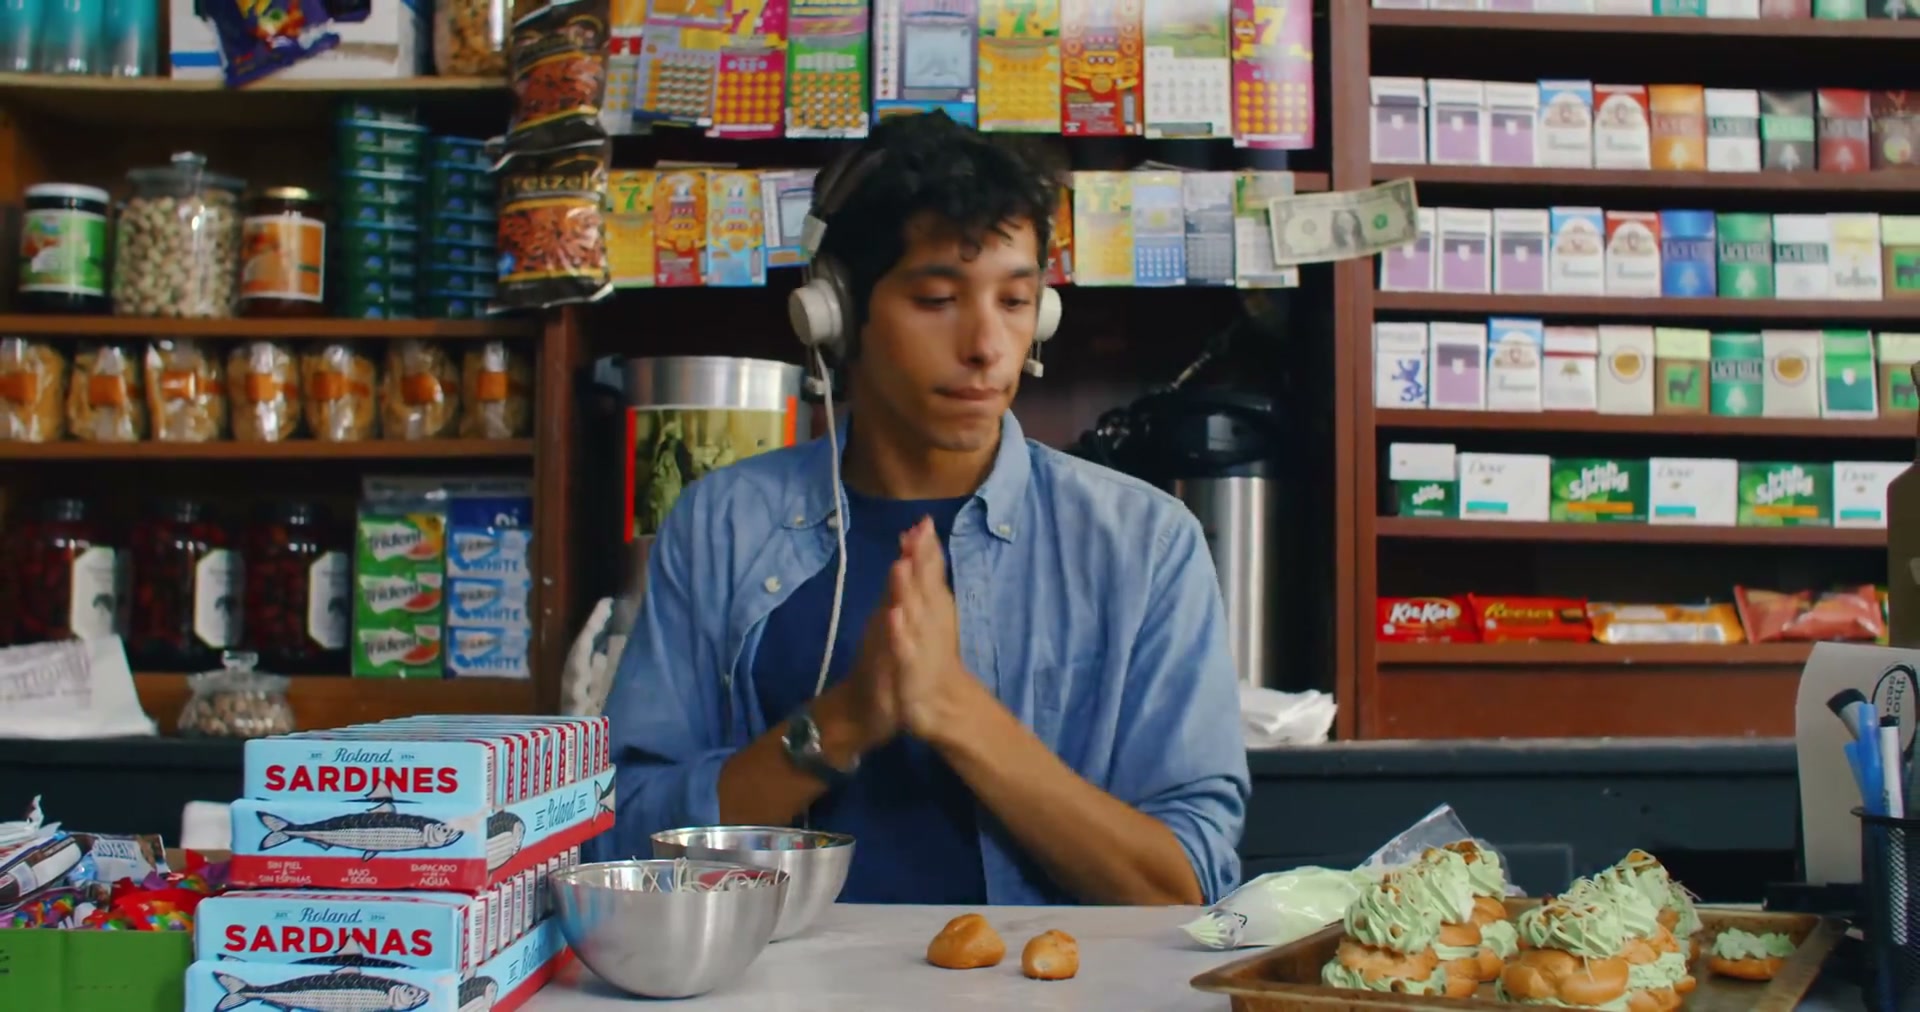
 BODEGA 01:20
保存的 AI 草稿 + 标注校正
Breakfast at the Bodega
先看原片选段,再对照镜头描述、时间和核对说明。
- 素材范围
- 80 秒
- 候选镜头
- 22 条
- 导出格式
- 6 种
覆盖约 14:25 原片的前 80 秒,保留校正与缺项。
先看 80 秒素材的 AI 拉片工作稿:22 条候选镜头,可下载 CSV。再看独立的三集编辑研究,把跨集变化、对应依据和尚未解答的问题放在一起。
BODEGA 01:20先看原片选段,再对照镜头描述、时间和核对说明。
覆盖约 14:25 原片的前 80 秒,保留校正与缺项。
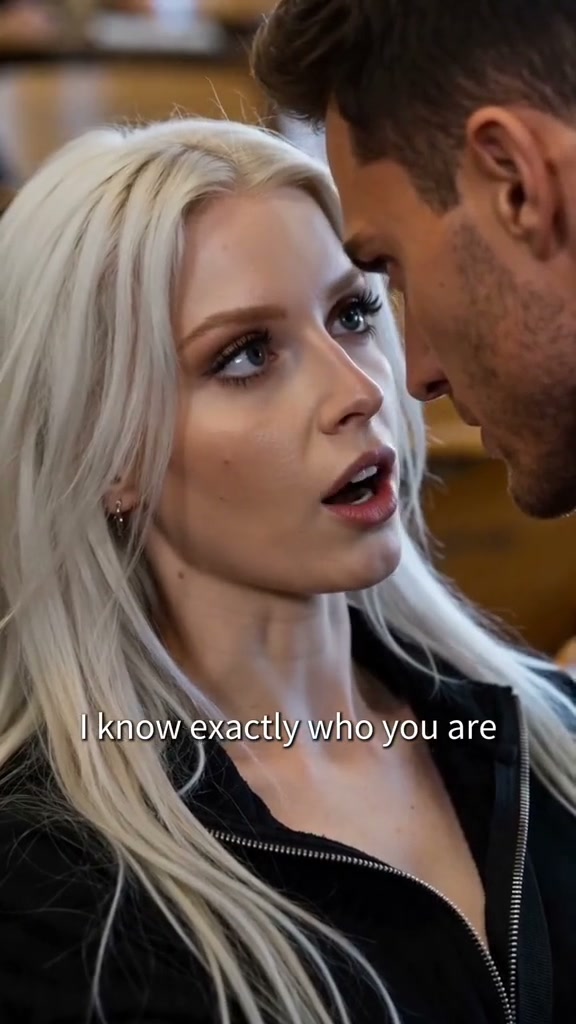 ZERO HOUR E01–E03
追踪一次反击怎样成为下一集的身份疑问,把观察和解读放在一起核对。
所选视觉笔记与编辑点评,时间为约数。
从片段到镜头表。查看已保存的 AI 镜头草稿及标注校正。每个镜头保留时间、描述和核对说明,便于回看素材、判断哪些内容可以使用、哪些还需确认。
本报告覆盖约 14 分 25 秒影片的前 80 秒,复用两份已有 AI 输出,并标注整理与校正。这不是全片分析,也不是已完成专业核验的终稿。
分析正文保留已有英文结果;章节、缺项与操作提供中文说明。
查看覆盖范围内全部 22 个候选镜头。选择一行可对照原片及全部字段;最后一行截断于样例边界。
缩略图抽帧时间 00:02.73 · 动作与声音请回看确认。
AI draft. Timing comes from automatic cut candidates. Emotions, intent and sound details require playback review; a sampled frame does not verify the full shot.
公共样例可查看字段并添加临时核对笔记;不保存对原始镜头行的修改。自己的视频结果在工作台编辑与保存。
CSV 包含已覆盖 80 秒内的全部 22 个候选镜头,不含 01:20 之后的分析;最后一行止于样例边界。
Zero Hour 是由既有审阅笔记整理的编辑研究;所选证据表与 Bodega 报告及导出分开。
Bodega 是自动切点候选,Zero Hour 是约数回看定位;两者都不是完整核验的剪辑表。
Zero Hour: A Queen Wakes
一次拒绝变成行动,行动又变成疑问。看看连续三集如何承接与改变。
复用已有视觉审阅与编辑点评。时间为约数,仅供回看;以下为人工整理的选段证据,不是完整三集自动分析交付。
左右滑动表格,查看完整的前后依据与状态 →
| 追踪问题 | 较早的依据 | 后续的依据 | 变化与解读 | 当前状态 |
|---|---|---|---|---|
| THREAD 01这次反击,为什么会引出身份问题? | E02 出现身体反击,为后续留下一个具体事件。 | E03 前集反击被用于追问训练与身份。 | 同一行动从当下反应,变为人物判断的线索。 编辑解读:事件的用途发生变化。 | 已承接 · 未解答 隐藏身份尚未证实,片名不能补足答案。 |
| THREAD 02人物边界与冲突,怎样延续? | E01 → E02 挑衅与拒绝,随后出现身体反抗。 场景笔记未给出精确时码。 | E03 更少旁人在场的对峙,让空间关系更加突出。 | 比较谁发起接触、谁希望结束,以及谁的行动受到限制。 距离变化与双方意图分别记录。 | 冲突继续 距离缩短,不能证明双方互有好感。 |
不把靠近写成亲密,也不从一次反击推导整个人物经历。
挑衅与拒绝构成互动模式。
接触与拒绝分别记录,双方吸引尚未成立。
更新人物抵抗的具体方式。
这是一条能力线索,人物过去仍未证实。
更少旁人在场,行动空间更关键。
更新距离、可接近程度与行动自由,保留意图的不确定性。
范围:第1—3集。在下方播放当前集并对照已有分析笔记;这不是完整的三集自动交付。
每个判断都对应集数依据和限制。约数时码仅供定位,不是核准剪辑点。
身份标签 → 反击表现 → 经历疑问。
外显身份与能力表现的差距,成为持续悬念。
公开对抗 → 身体反击 → 更少旁人在场的对峙。
比较接近权限、人物距离与行动自由的变化,不把靠近自动解读成感情进展。
旁人反应 → 势力背景 → 更大影响力的声称。
把角色对外部机构的说法,与剧情已经展示的规则分开记录。
持续关注 → 能力疑问 → 身份追问延续。
前集行动因用途变化而重新推动剧情。片头预览不应重复计作一次事件。
清晰反应 → 动作插入 → 更紧的空间构图。
近景承载反应,较宽构图交代谁限制了谁的行动;二者交替改变了近距离的含义。
不随众服从 → 有效反击 → 被评价为警觉。
先记录能力线索。稳定优势需要可重复的证据、触发条件与限制。
让行动解决当下问题,再用其含义产生下一次追问。保留原事件与后续解释的关联;前提是后续问题确实有画面依据。
随对话升级改变距离和可移动空间。先用较宽构图交代身体关系,再依靠近景反应;空间不清时,靠近容易被误读。
区分场景内的行动与尚未解决的跨集问题。结尾可收束当前节拍,同时保留动机疑问;没有受众数据,不宣称这种做法提升留存。
来自 Blender 开放电影的真实片段,按 CC BY 4.0 标注来源署名。所选画面分别提供可见观察与分析解释;这不是自动模型运行结果,也不是全片完整镜头表。
切换影片会保留各自笔记,刷新清空;导出包含笔记和来源署名。无需账号,不扣积分。
上传你的素材后,工作台提供原片回看、版本保存与文档导出。用于拍摄前,请核对 AI 观察与解释。